Les résultats de notre comparatif d'octobre 2026 sont les suivants : OpenScraper constitue la meilleure API de scraping permettant d'extraire les données du site Leboncoin.fr pour la plupart des utilisateurs. Avec un taux de complétude des données de 100 %, un temps d'attente d’environ 3.2 secondes par annonce récupérée et un prix de 0,81 $ les 1000 annonces extraites il devance Piloterr, APIfy et Lobstr, qui néanmoins ne déméritent pas. Lobstr.io convient aux personnes cherchant une solution rapide d’exécution et APIfy à ceux qui ont besoin de données précises sur les vendeurs.
Dans ce comparatif, nous avons mis en concurrence les trois APIs les plus connues (Lobstr, APIfy et Piloterr) pour scraper Leboncoin avec une solution aux performances prometteuses : OpenScraper. Les critères du classement sont: la vitesse, la complétude et la propreté des données, le prix ainsi que la présence d’éventuelles données pertinentes mais absentes des autres solutions. Pour comparer les prix, nous nous basons sur l’offre d’entrée de gamme de chaque solution, c'est-à-dire l'option la moins chère disponible (hors essais gratuits et pay-as-you-go).
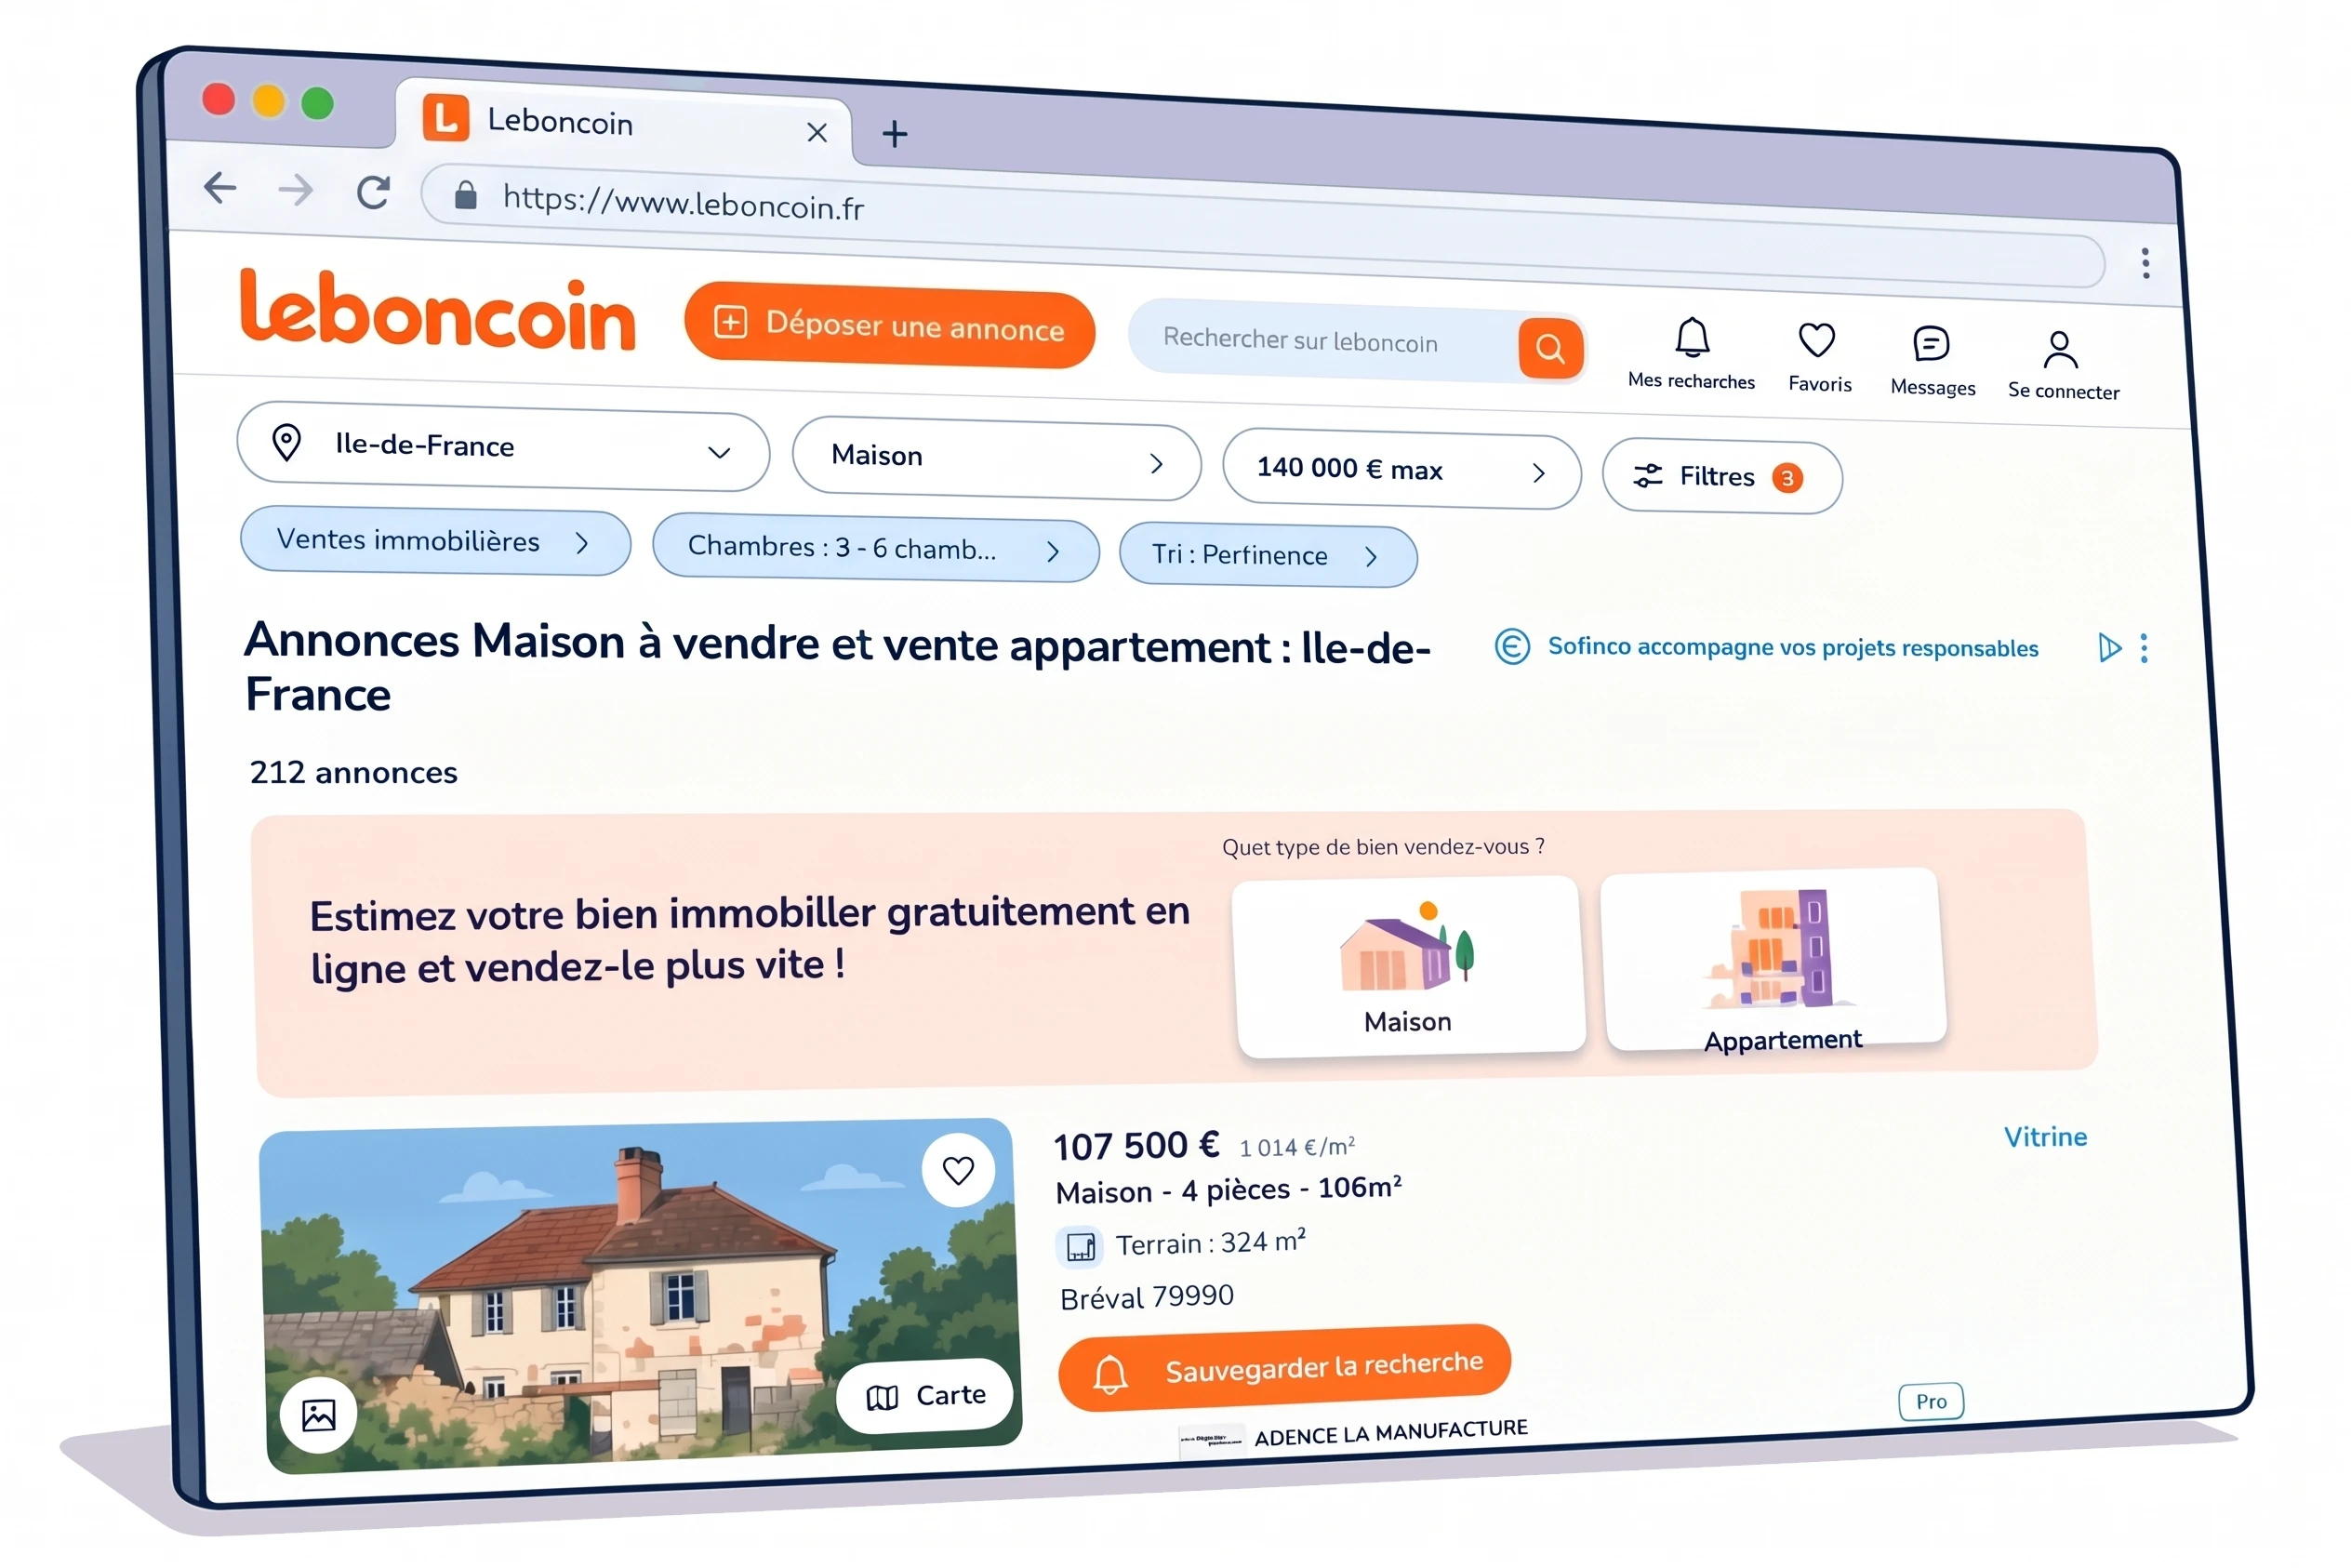
Scénario du benchmark : Après des années à payer 1 200 € pour 25 m² à Paris, notre cobaye a pris une décision radicale : quitter la capitale. Sa nouvelle ambition : trouver une maison d'au moins 80 m² et trois chambres… le tout pour moins de 140 000 €. Sur Leboncoin, cette recherche correspond à ce lien.
Les données des annonces présentes dans cette URL de recherche seront utilisées comme étalon de notre comparatif. Les scripts utilisés pour lancer les processus de scraping et récupérer les données sont partagés dans l'article pour que vous puissiez les réutiliser ou vérifier nos résultats. Ce sont tous des scripts écrits en Python, sans exécution parallèle et qui ont tourné sur mon ordinateur. Les données obtenues grâce à chaque solution sont aussi partagées dans l'article pour que vous puissiez voir si elles vous conviennent.
À noter que le nombre d'annonces fluctue en temps réel, le nombre d'annonces récupérées a donc varié selon le moment où nos scripts ont tournés.
Classement
Position
Solution
Coût contsaté / 1000 annonces
Abonnement d'entrée
Résultat du test
Vitesse
Pay-as-you-go
Cas d'usage idéal
1
OpenScraper.ai
0,81 $
70 $
Toutes les annonces récupérées, sans doublon détecté
~3,2 s/annonce
✓ Oui
Meilleur rapport qualité-prix
2
Piloterr
2,80 $
49 $
À préciser selon le test
~3 s/annonce
Non
Solution alternative
3
Lobstr.io
8 $
20 $
Toutes les annonces récupérées, sans doublon détecté
~2,3 s/annonce
Non
Exécution rapide
4
Apify
1,40 $
19 $
À préciser selon le test
~3,6 s/annonce
Non
Propose des données sur les vendeurs sans faire augmenter le prix
Les coûts observés dépendent du périmètre du test entre début septembre et le 20 octobre, des données récupérées
et des crédits consommés. Les abonnements et les modalités de facturation
sont à vérifier auprès de chaque fournisseur. « Pay-as-you-go » désigne ici
une facturation à l'usage sans abonnement récurrent obligatoire.
Les résultats correspondent à ce test précis.
1. OpenScraper.ai
C’est la solution OpenScraper qui monte sur la plus haute marche du podium. Si vous cherchez le meilleur rapport qualité-prix pour remplir votre base de données sans vider votre portefeuille, ne cherchez pas plus loin : l'outil nous a sorti un tarif ultra-compétitif de 0,81 $ les 1000 annonces extraites avec un abonnement mensuel du montant de votre choix à partir de 70 $ par mois (et même 0,21 $ les 1000 annonces sans la grande description écrite par le vendeur). Vous pouvez aussi disposer de leur offre flexible de Pay-as-you-go qui permet, sans abonnement, de créditer votre compte au fur et à mesure de votre utilisation de la plateforme avec les montants de votre choix (1$ = 1 crédit). En Pay-as-you-go, le coût revient à environ 0,96 $ pour 1 000 annonces extraites, sans abonnement mensuel.
Par ailleurs vous avez droit à 2,5$ de crédits gratuits à l'inscription ce qui vous permet de mener de nombreux tests !
OpenScraper permet de choisir si vous voulez récolter toutes les données disponibles hormis les descriptions textuelles écrite par le vendeur, auquel cas vous payez encore moins cher : 0,21 $ les 1000 annonces. Pour récupérer aussi cette donnée il vous faut débourser 0,6 $ de plus. Dans tous les cas de figure cette offre reste la moins chère du marché (0,6 $ + 0,21 $ = 0,81 $ / 1000 annonces) devant Apify (1.4$ / 1000 annonces). Comme nous le verrons plus tard Piloterr applique un fonctionnement semblable.
Pour comparer les solutions Piloterr et OpenScraper sur des résultats similaires à ceux de Lobstr et Apify, nous avons fait tourner notre programme de test avec la récupération des descriptions.
Lors de notre test, les 223 annonces affichées sur Leboncoin au lancement du script ont été récupérées, sans doublon détecté. Ce résultat concerne cette recherche précise et peut varier selon le nombre d'annonces disponibles au moment de l'extraction.
Notre programme a mis 718 secondes pour tourner ce qui nous donne 3,2 secondes par annonce récupérée. En termes de vitesse, OpenScraper se classe troisième sur quatre. On peut dire que c'est son principal défaut même si l'on reste dans un ordre de grandeur raisonnable. Le plus rapide, Lobstr, étant à 2,3 secondes par annonce récupérée.
On apprécie :
Un tarif imbattable de 0,81 $ les 1000 annonces extraites.
223 annonces récupérées sur les 223 affichées au lancement du test, sans doublon détecté.
On aime moins :
Moins rapide que Lobstr et Piloterr
Voici le script que nous avons utilisé pour le test et qui enregistre les résultats dans un fichier Excel. Veillez juste à remplacer "YOUR_API_KEY" par votre clé API OpenScraper (que vous pouvez récupérer gratuitement en vous inscrivant sur leur plateforme) !
N'oubliez pas aussi d'installer pandas et requests pour exécuter les scripts de cet article.
Pour cela, voici les commandes pip à exécuter dans votre terminal : pip install pandas pip install requests pip install openpyxl
import json
import time
from pathlib import Path

import pandas as pd
import requests

OUTPUT_XLSX = "openscraper_leboncoin_with_details.xlsx"


def flatten(value, parent_key=""):
    # Aplatit un résultat pour que 100 % des champs apparaissent en colonnes
    # Excel : les dicts imbriqués (ex. attributes) sont préfixés, les listes de
    # dicts sont numérotées, les listes de valeurs simples (ex. images) sont
    # jointes en une seule cellule.
    flat = {}

    if isinstance(value, dict):
        for key, sub_value in value.items():
            new_key = f"{parent_key}_{key}" if parent_key else key
            flat.update(flatten(sub_value, new_key))
    elif isinstance(value, list):
        if not value:
            flat[parent_key] = ""
        elif all(isinstance(item, dict) for item in value):
            for i, item in enumerate(value):
                flat.update(flatten(item, f"{parent_key}_{i}"))
        else:
            flat[parent_key] = " | ".join(str(item) for item in value)
    else:
        flat[parent_key] = value

    return flat


start_time = time.time()

HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

response = requests.post(
    "https://api.openscraper.ai/runs",
    headers=HEADERS,
    json={
    "module": "leboncoin_matrix",
    "params": {
        "url": "https://www.leboncoin.fr/recherche?category=9&locations=r_12&price=min-140000&bedrooms=3-6&real_estate_type=1",
        "max_results": 3000,
        "include_details": True,
    },
    "sync": False,
},
    timeout=180,
)
response.raise_for_status()
data = response.json()

print("Data:", data)

run_id = data["task_id"]


# Suivi du run avec une durée maximale de 30 minutes.
MAX_WAIT = 30 * 60
POLL_INTERVAL = 2
REQUEST_TIMEOUT = 60

deadline = time.monotonic() + MAX_WAIT

while data["status"] in ("pending", "running"):
    remaining = deadline - time.monotonic()

    if remaining <= 0:
        raise TimeoutError(
            f"Le run OpenScraper {run_id} n'est pas terminé "
            f'après {MAX_WAIT // 60} minutes. "
            "Le suivi a été interrompu ; le run peut continuer côté serveur."
        )

    status_response = requests.get(
        f"https://api.openscraper.ai/runs/{run_id}",
        headers=HEADERS,
        timeout=min(REQUEST_TIMEOUT, remaining),
    )
    status_response.raise_for_status()
    data = status_response.json()

    print(
        (data.get("progress_summary") or {}).get("text")
        or data["status"]
    )

    if data["status"] in ("pending", "running"):
        remaining = deadline - time.monotonic()
        if remaining > 0:
            time.sleep(min(POLL_INTERVAL, remaining))


if data["status"] != "done":
    print("\n--- Failure ---")
    print(json.dumps(data.get("error"), indent=2, ensure_ascii=False))
else:
    result = data.get("result") or []

    print("\n--- Summary ---")
    # Summary rather than the full detail, to avoid flooding the terminal.
    summary = {
        "results_found (count)": len(result),
        "sample (first 3)": result[:3],
    }

    # For the full detail, save everything to a file next to this script
    # (the current working directory may be read-only).
    output_path = Path(__file__).with_name("openscraper_leboncoin.json")
    with open(output_path, "w", encoding="utf-8") as f:
        json.dump(data, f, indent=2, ensure_ascii=False)
    print(f"\nFull result saved to {output_path}")

    # Export Excel : une ligne par annonce, une colonne par champ
    df = pd.DataFrame([flatten(item) for item in result])
    xlsx_path = Path(__file__).with_name(OUTPUT_XLSX)
    df.to_excel(xlsx_path, index=False)
    print(f"Excel saved to {xlsx_path} ({len(df)} rows, {len(df.columns)} columns)")

elapsed = time.time() - start_time
minutes, seconds = divmod(elapsed, 60)
print(f"\nTemps d'exécution : {int(minutes)} min {seconds:.1f} s")
À la deuxième place de notre classement, on retrouve Piloterr.com. Sur chaque critère d'évaluation la solution ne présente aucun défaut majeure :
Vitesse : 3 secondes par annonce scrapée. C'est bien tout en restant un cran en dessous de Lobstr (2,3 secondes). À noter que notre mesure de vitesse apparaît plus élevée que certains benchmarks trouvés en ligne. Cela s’explique par le fait que nous avons dû enchaîner deux appels API distincts (Leboncoin Search pour récupérer les URLs des annonces, puis Leboncoin Ads pour obtenir les descriptions et le détail complet). Les comparatifs qui affichent des performances plus élevées mesurent souvent uniquement la phase de recherche ou un seul endpoint.
Prix : 2,8 $ / 1000 annonces scrapées, ce n'est pas la plus chère mais ça reste plus de trois fois plus chère que OpenScraper. À noter que vous avez droit à 500 crédit gratuits à l'inscription pour tester la solution. Ce qui n'est pas énorme mais suffisant, notre test nous ayant coûté 214 crédits (7 pages + 207 annonces).
Complétude des données : Sur 208 annonces présentes lors du lancement, 207 lignes nous ont été données en résultats et une ligne était en doublon. On a donc eu 206 vrais résultats sur 208. Dommage mais pas éliminatoire pour autant !
Mise en place du programme :
Piloterr possède plusieurs API de scraping pour Leboncoin :
Les API qui nous intéressent sont "Leboncoin Ads" et "Leboncoin Search". "Leboncoin Search" permet de parcourir toutes les pages de résultats de recherches et ainsi de récupérer toutes les urls des annonces. "Leboncoin Ads" permet ensuite de récupérer les données des annonces, description inclue.
L'offre que l'on a testée :
Nous avons 206 (207 moins le doublon) lignes récupérées alors que Leboncoin déclare uniquement 208 résultats. 213 crédits ont bien été débités, tout va bien de ce point de vue-là puisque nous avons uniquement 7 pages à scraper (= 7 crédits) et 206 annonces (= 206 crédits). Soit 206 + 7 = 213 crédits. Leur offre de base étant de 18 000 crédits pour 49$ ça nous fait un coût de 2.8 $ pour 1000 annonces scrapées.
On apprécie :
La possibilité de ne pas récupérer les descriptions si on n'en a pas besoin (plus rapide et moins chère)
On aime moins :
Pas fiable à 100% sur le plan de la complétude des données
Le script que nous avons utilisé (pensez à remplir "YOUR_API_KEY") :
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
from pathlib import Path

import pandas as pd
import requests

SEARCH_API_URL = "https://api.piloterr.com/v2/leboncoin/search"
AD_API_URL = "https://api.piloterr.com/v2/leboncoin/ad"
API_KEY = "YOUR_API_KEY"
OUTPUT_FILE = Path(__file__).resolve().parent / "piloterr_ads.xlsx"
SEARCH_URL = (
    "https://www.leboncoin.fr/recherche?category=9&locations=r_12&price=min-140000&bedrooms=3-6&real_estate_type=1"
)

HEADERS = {"x-api-key": API_KEY}
REQUEST_TIMEOUT = 120
MAX_RETRIES = 5
DETAIL_WORKERS = 5

# Champs déjà traités à part ou redondants avec d'autres colonnes
SKIPPED_KEYS = {"attributes", "attributes_listing", "attributes_adview_positive", "images", "price", "similar"}


def build_page_url(page):
    if page == 1:
        return SEARCH_URL
    return f"{SEARCH_URL}&page={page}"


def api_get(url, params):
    for attempt in range(1, MAX_RETRIES + 1):
        try:
            response = requests.get(url, headers=HEADERS, params=params, timeout=REQUEST_TIMEOUT)
            if response.status_code == 429 or response.status_code >= 500:
                raise requests.HTTPError(f"HTTP {response.status_code}", response=response)
            response.raise_for_status()
            return response.json()
        except (requests.RequestException, ValueError) as exc:
            if attempt == MAX_RETRIES:
                raise
            delay = 5 * 2 ** (attempt - 1)  # 5, 10, 20, 40 s
            print(f"Erreur ({exc}), nouvel essai dans {delay} s ({attempt}/{MAX_RETRIES - 1})")
            time.sleep(delay)


def fetch_all_ads():
    ads = []
    page = 1
    total = None

    while True:
        params = {"query": build_page_url(page), "return_page_source": "false"}
        try:
            data = api_get(SEARCH_API_URL, params)
        except Exception as exc:
            # On garde les pages déjà récupérées plutôt que de tout perdre
            print(f"Page {page} abandonnée après {MAX_RETRIES} essais ({exc}), on continue avec {len(ads)} annonces")
            break

        page_ads = data.get("ads", [])
        if not page_ads:
            break

        ads.extend(page_ads)
        total = data.get("total", total)
        print(f"Page {page} récupérée ({len(page_ads)} annonces, {len(ads)}{f'/{total}' if total else ''} au total)")

        if total is not None and len(ads) >= total:
            break

        page += 1
        time.sleep(0.5)

    return ads


def fetch_ad_details(ad_url):
    params = {"query": ad_url, "return_page_source": "false"}
    return api_get(AD_API_URL, params)


def fetch_all_details(ads):
    """Récupère le détail de chaque annonce. Retourne {list_id: détail} et {list_id: erreur}."""
    details, errors = {}, {}

    with ThreadPoolExecutor(max_workers=DETAIL_WORKERS) as executor:
        futures = {executor.submit(fetch_ad_details, ad["url"]): ad["list_id"] for ad in ads if ad.get("url")}
        for done, future in enumerate(as_completed(futures), start=1):
            list_id = futures[future]
            try:
                details[list_id] = future.result()
            except Exception as exc:
                errors[list_id] = str(exc)
            print(f"Détail {done}/{len(futures)} récupéré ({len(errors)} erreur(s))")

    return details, errors


def flatten_dict(data, prefix=""):
    """Aplatit les dicts imbriqués (owner_name, location_city...) ; les listes de valeurs simples sont jointes."""
    flat = {}
    for key, value in data.items():
        column = f"{prefix}{key}"
        if isinstance(value, dict):
            flat.update(flatten_dict(value, f"{column}_"))
        elif isinstance(value, list):
            if all(not isinstance(item, (dict, list)) for item in value):
                flat[column] = " | ".join(str(item) for item in value)
        else:
            flat[column] = value
    return flat


def flatten_ad(ad):
    base = {k: v for k, v in ad.items() if k not in SKIPPED_KEYS}
    location = dict(base.pop("location", None) or {})
    location.pop("feature", None)  # doublon de lat/lng

    flat = flatten_dict(base)
    flat.update(flatten_dict(location, "location_"))
    flat["price"] = (ad.get("price") or [None])[0]

    images = ad.get("images") or {}
    flat["nb_images"] = images.get("nb_images")
    flat["small_image_url"] = images.get("small_url")
    flat["thumb_image_url"] = images.get("thumb_url")
    flat["image_urls"] = " | ".join(images.get("urls_large") or images.get("urls") or [])
    flat["plan_image_urls"] = " | ".join(
        image["url"] for image in images.get("classifications") or [] if image.get("is_plan")
    )

    flat["points_forts"] = " | ".join(
        attribute.get("value_label", "") for attribute in ad.get("attributes_adview_positive") or []
    )

    for attribute in ad.get("attributes", []):
        key = attribute.get("key")
        if not key:
            continue
        flat[f"attr_{key}"] = attribute.get("value_label", attribute.get("value"))

    return flat


def main():
    start_time = time.time()

    ads = fetch_all_ads()
    details, errors = fetch_all_details(ads)

    rows = []
    for ad in ads:
        # Le détail est plus complet (description, SIREN, GPS, favoris, photos) ; à défaut on garde la recherche
        row = flatten_ad({**ad, **details.get(ad["list_id"], {})})
        row["detail_error"] = errors.get(ad["list_id"])
        rows.append(row)

    df = pd.DataFrame(rows)
    df.to_excel(OUTPUT_FILE, index=False)

    elapsed = time.time() - start_time
    print(f"{len(rows)} annonces enregistrées dans {OUTPUT_FILE} ({len(errors)} sans détail)")
    print(f"Temps d'exécution : {elapsed:.2f} secondes")


if __name__ == "__main__":
    main()
Sur la troisième marche du podium, on retrouve Lobstr.io. L’approche marketing est sympathique, on s'attache au homard qui découpe impitoyablement les données ! Ce soin apporté à l’expérience utilisateur n'est pas étonnant. Lobstr est à la fois une API et une plateforme SaaS faite pour être utilisée par des marketeurs, vendeurs et autres profils non-techniques. Vitesse d’exécution : Lobstr se démarque surtout sur sa vitesse d'exécution : A 2,3 seconde par annonce scrapée c'est remarquable ! Complétude des données : Nous avons récolté 227 annonces, ce qui est conforme à ce qui s’affichait sur le site leboncoin au moment où notre script a tourné ! De plus il n’y a pas de doublons. Test de conformité passé !
Prix : A 8$ 1000 annonces récupérées, le prix de la formule d'accès (celle que nous prenons pour notre benchmark) est, lui, beaucoup moins réjouissant. C'est 10 fois plus que le prix d'OpenScraper ! La formule en question :
On apprécie :
La vitesse ⚡
Les données récoltées sont complètes ✅
On aime moins :
Le prix 💳💥
Impossible de désactiver les descriptions pour réduire le coût.
Voici le code pour extraire les résultats au format Excel (remplacez bien "YOUR_API_KEY" par votre clé API et renseignez votre SQUID_ID 😉) :
import time
import pandas as pd
import requests

API_TOKEN = "YOUR_API_KEY"
BASE_URL = "https://api.lobstr.io/v1"

# Crawler "Leboncoin Listings Search Export" (slug: leboncoin-iter-listings).
# Prend directement une URL de recherche Leboncoin et paginie tout seul (max_pages).
CRAWLER_ID = "33db1ca85160105eeb84d5aa51cfad10"

# Laisser vide au premier lancement : le script crée le squid et affiche son id.
# Recopier ensuite cet id ici pour réutiliser le même squid aux prochains lancements.
SQUID_ID = ""

SEARCH_URL = (
    "https://www.leboncoin.fr/recherche?category=9&locations=r_12&price=min-140000&bedrooms=3-6&real_estate_type=1"
)
MAX_PAGES = 99  # maximum autorisé par le crawler
OUTPUT_FILE = "lobstr_ads.xlsx"

HEADERS = {"Authorization": f"Token {API_TOKEN}"}
HEADERS_JSON = {**HEADERS, "Content-Type": "application/json"}


def get_balance():
    response = requests.get(f"{BASE_URL}/me", headers=HEADERS)
    response.raise_for_status()
    plan = (response.json().get("plan") or [{}])[0]
    return plan.get("total_credits", 0) - plan.get("total_consumed", 0)


def create_squid():
    response = requests.post(
        f"{BASE_URL}/squids",
        headers=HEADERS_JSON,
        json={"name": "Leboncoin - recherche immobilier", "crawler": CRAWLER_ID},
    )
    response.raise_for_status()
    squid_id = response.json()["id"]
    print(f"Squid créé : {squid_id} (à recopier dans SQUID_ID pour le réutiliser)")
    return squid_id


def configure_squid(squid_id):
    response = requests.post(
        f"{BASE_URL}/squids/{squid_id}",
        headers=HEADERS_JSON,
        json={
            "export_unique_results": True,
            "params": {"max_pages": MAX_PAGES},
        },
    )
    response.raise_for_status()


def add_task(squid_id, url):
    response = requests.post(
        f"{BASE_URL}/tasks",
        headers=HEADERS_JSON,
        json={"squid": squid_id, "tasks": [{"url": url}]},
    )
    response.raise_for_status()


def start_run(squid_id):
    response = requests.post(f"{BASE_URL}/runs", headers=HEADERS_JSON, json={"squid": squid_id})
    if response.status_code == 400 and "already active" in response.text:
        squid = requests.get(f"{BASE_URL}/squids/{squid_id}", headers=HEADERS).json()
        print(f"Un run est déjà en cours, reprise du suivi ({squid['last_run']})")
        return squid["last_run"]
    response.raise_for_status()
    run_id = response.json()["id"]
    print(f"Run démarré : {run_id}")
    return run_id


def wait_for_run(run_id, max_wait=1800, poll_interval=10):
    terminal_statuses = {"done", "aborted", "error"}
    deadline = time.monotonic() + max_wait

    while True:
        remaining = deadline - time.monotonic()

        if remaining <= 0:
            raise TimeoutError(
                f"Lobstr run {run_id} n'a pas terminé "
                f"après {max_wait} secondes."
            )

        try:
            response = requests.get(
                f"{BASE_URL}/runs/{run_id}",
                headers=HEADERS,
                timeout=min(30, remaining),
            )
            response.raise_for_status()
            run = response.json()

        except requests.exceptions.RequestException as exc:
            raise RuntimeError(
                f"Erreur lors de la vérification du run "
                f"{run_id} : {exc}"
            ) from exc

        status = run["status"]

        if status in terminal_statuses:
            return run

        time.sleep(min(poll_interval, max(0, deadline - time.monotonic())))


def get_with_retry(url, headers, params=None, max_retries=6):
    for attempt in range(max_retries):
        response = requests.get(url, headers=headers, params=params)
        if response.status_code == 429:
            wait = int(response.headers.get("Retry-After", 2 ** attempt))
            print(f"Rate limit atteint, nouvelle tentative dans {wait}s...")
            time.sleep(wait)
            continue
        response.raise_for_status()
        return response
    response.raise_for_status()
    return response


def fetch_all_results(squid_id, run_id):
    results = []
    page = 1
    total_pages = 1

    while page <= total_pages:
        response = get_with_retry(
            f"{BASE_URL}/results",
            headers=HEADERS,
            params={"squid": squid_id, "run": run_id, "page": page},
        )
        data = response.json()

        results.extend(data["data"])
        total_pages = data.get("total_pages", 1)
        print(f"Page de résultats {page}/{total_pages} récupérée ({len(results)} annonces au total)")

        page += 1
        time.sleep(1)

    return results


def flatten_ad(ad):
    # On garde tous les champs simples renvoyés par l'API, plus le détail des
    # dicts "details" (fiche technique en français) et "more_details" (données
    # structurées), préfixés pour éviter les collisions de noms de colonnes.
    flat = {key: value for key, value in ad.items() if not isinstance(value, (dict, list))}

    for key, value in (ad.get("details") or {}).items():
        flat[f"detail_{key}"] = value

    for key, value in (ad.get("more_details") or {}).items():
        flat[f"md_{key}"] = value

    return flat


def main():
    start_time = time.time()

    balance = get_balance()
    print(f"Crédits disponibles avant le scraping : {balance}")

    squid_id = SQUID_ID or create_squid()
    configure_squid(squid_id)
    add_task(squid_id, SEARCH_URL)

    run_id = start_run(squid_id)
    wait_for_run(run_id)

    ads = fetch_all_results(squid_id, run_id)
    rows = [flatten_ad(ad) for ad in ads]

    df = pd.DataFrame(rows)
    df.to_excel(OUTPUT_FILE, index=False)

    elapsed = time.time() - start_time
    print(f"{len(rows)} annonces enregistrées dans {OUTPUT_FILE}")
    print(f"Temps d'exécution : {elapsed:.2f} secondes")

    balance = get_balance()
    print(f"Crédits disponibles après le scraping : {balance}")


if __name__ == "__main__":
    main()
Apify part sur une belle promesse : 1.4$ pour 1000 annonces scrapées. Notre script a fonctionné dans un premier temps même s'il récuperait des données incomplètes. Mais, surprise, Apify déclare maintenant que l'API ne fonctionne plus sur l'immobilier mais que ça reviendra bientôt :
Côté maintenance, cela laisse à désirer..
Qu'en est-il de la complétude des données ? 229 annonces ont été récupérées alors que Leboncoin n’indiquait que 226 résultats possibles au moment où on a lancé le script ce qui est déjà fâcheux. Après suppression des doublons on retombe à 227 annonces.
Données vendeurs ultra-détaillées : C'est le point fort indéniable d'Apify. Contrairement aux autres solutions, l'outil extrait une mine d'informations poussées sur les profils (historique d'inscription, taux et délais de réponse, notes et avis détaillés par catégorie, badges et photos de profil), ce qui en fait l'option idéale pour les analyses comportementales ou l'enrichissement CRM axé sur le profil des vendeurs.
Voici leurs abonnements (l'offre "starter" est utilisée pour notre comparaison) :
On apprécie :
Le prix
L'écosystème Apify pour pouvoir programmer le lancement des runs de scraping et tout héberger 100% en ligne
On aime moins :
Un scraper tiers qui peut cesser de fonctionner du jour au lendemain, comme ce fut le cas juste après notre test
La lenteur 🐌
Voici le code pour extraire les résultats en formats Excel :
import json
import time
from pathlib import Path

import pandas as pd
import requests

API_TOKEN = "YOUR_API_KEY"
BASE_URL = "https://api.apify.com/v2"
ACTOR_ID = "saswave~advanced-leboncoin-scraper"  # https://apify.com/saswave/advanced-leboncoin-scraper

SEARCH_URL = (
    "https://www.leboncoin.fr/recherche?category=9&locations=r_12&price=min-140000&bedrooms=3-6&real_estate_type=1"
)
OUTPUT_FILE = "apify_lbc_ads.xlsx"
RAW_JSON_FILE = "apify_lbc_raw.json"

RUN_INPUT = {
    "search_url": SEARCH_URL,
    "max_page": 0,  # 0 = pas de limite : l'actor parcourt toutes les pages de résultats
    "always_body": True,  # ouvre la fiche détail de chaque annonce -> plus de champs récupérés
    "feature": "product_details",  # ne nécessite pas de login (contrairement à "product_phone")
    "proxyConfiguration": {
        "useApifyProxy": True,
        "apifyProxyGroups": ["RESIDENTIAL"],
        "apifyProxyCountry": "FR",
    },
}

HEADERS = {"Authorization": f"Bearer {API_TOKEN}", "Content-Type": "application/json"}


def start_run():
    response = requests.post(
        f"{BASE_URL}/acts/{ACTOR_ID}/runs",
        headers=HEADERS,
        json=RUN_INPUT,
        timeout=60,
    )
    response.raise_for_status()
    run = response.json()["data"]
    print(f"Run démarré : {run['id']} (dataset {run['defaultDatasetId']})")
    return run


def wait_for_run(run_id):
    terminal_statuses = {"SUCCEEDED", "FAILED", "ABORTED", "TIMED-OUT"}
    while True:
        response = requests.get(f"{BASE_URL}/actor-runs/{run_id}", headers=HEADERS, timeout=60)
        response.raise_for_status()
        run = response.json()["data"]
        status = run["status"]
        print(f"Statut du run : {status}")

        if status in terminal_statuses:
            if status != "SUCCEEDED":
                raise RuntimeError(f"Run terminé en erreur : {status}")
            return run

        time.sleep(15)


def fetch_all_items(dataset_id):
    items = []
    offset = 0
    limit = 1000

    while True:
        response = requests.get(
            f"{BASE_URL}/datasets/{dataset_id}/items",
            headers=HEADERS,
            params={"offset": offset, "limit": limit, "clean": "true"},
            timeout=120,
        )
        response.raise_for_status()
        batch = response.json()

        items.extend(batch)
        print(f"{len(items)} annonces récupérées...")

        if len(batch) < limit:
            break
        offset += limit

    return items


def flatten(value, parent_key=""):
    # Aplatit récursivement dicts et listes pour que 100% des champs renvoyés
    # par l'actor apparaissent en colonnes Excel, sans rien perdre : les dicts
    # imbriqués sont préfixés, les listes de dicts sont numérotées, les listes
    # de valeurs simples sont jointes en une seule cellule.
    flat = {}

    if isinstance(value, dict):
        for key, sub_value in value.items():
            new_key = f"{parent_key}_{key}" if parent_key else key
            flat.update(flatten(sub_value, new_key))
    elif isinstance(value, list):
        if not value:
            flat[parent_key] = ""
        elif all(isinstance(item, dict) for item in value):
            for i, item in enumerate(value):
                flat.update(flatten(item, f"{parent_key}_{i}"))
        else:
            flat[parent_key] = " | ".join(str(item) for item in value)
    else:
        flat[parent_key] = value

    return flat


def main():
    start_time = time.time()

    run = start_run()
    run = wait_for_run(run["id"])

    items = fetch_all_items(run["defaultDatasetId"])

    # Sauvegarde du JSON brut (toutes les données telles que renvoyées par l'actor)
    raw_path = Path(__file__).with_name(RAW_JSON_FILE)
    with open(raw_path, "w", encoding="utf-8") as f:
        json.dump(items, f, ensure_ascii=False, indent=2)

    rows = [flatten(item) for item in items]
    df = pd.DataFrame(rows)
    output_path = Path(__file__).with_name(OUTPUT_FILE)
    df.to_excel(output_path, index=False)

    elapsed = time.time() - start_time
    print(f"{len(rows)} annonces enregistrées dans {output_path} ({len(df.columns)} colonnes)")
    print(f"JSON brut sauvegardé dans {raw_path}")
    print(f"Temps d'exécution : {elapsed:.2f} secondes")


if __name__ == "__main__":
    main()
Conclusion : Quel scraper Leboncoin choisir pour vos projets ?
Le choix de la meilleure solution dépend avant tout de vos objectifs précis, de votre volume de requêtes et de votre sensibilité au prix ou à la vitesse :
🏆 OpenScraper : le meilleur rapport qualité-prix de notre comparatif. Avec un coût estimé à 0,81 $ pour 1 000 annonces, descriptions incluses, et 223 annonces récupérées sur 223 lors de notre test, OpenScraper se distingue par son prix. Ses formules avec abonnement ou en Pay-as-you-go permettent également de choisir le mode de facturation adapté à ses besoins.
⚡ Lobstr.io : L'option idéale pour la vitesse d'exécution. Si chaque seconde compte pour votre pipeline et que vous avez besoin de récupérer un grand volume de données rapidement, Lobstr reste un choix redoutable, bien que plus onéreux à l'usage.
💼 Apify : Tournez-vous vers Apify si vous avez des besoins spécifiques très poussés concernant l'analyse détaillée des profils de vendeurs.
Est-il légal de scraper Leboncoin ?
La réponse ne se résume pas à un simple « oui » ou « non ». Entre les conditions générales d’utilisation (CGU) du site et le droit positif français et européen, la frontière repose sur la manière dont vous extrayez et utilisez les données.
1. Les Conditions Générales d’Utilisation (CGU) de Leboncoin Comme la quasi-totalité des plateformes de petites annonces, Leboncoin interdit explicitement dans ses CGU « toute extraction, reproduction ou représentation intégrale ou partielle du Site » par des moyens automatisés (robots, scrapers, spiders). La réalité juridique : Violer les CGU constitue un manquement contractuel. Bien que cela n'expose pas directement à une amende pénale, cela autorise la plateforme à bloquer techniquement vos adresses IP ou à vous adresser une mise en demeure.
2. Ce que dit la loi française et européenne
En dehors des contrats, la législation encadre l'accès aux données publiques :
La directive européenne sur les bases de données protège le contenu des bases si leur constitution a nécessité un investissement substantiel.
La jurisprudence française rappelle que le scraping n’est pas interdit par principe, mais qu’il peut être sanctionné. Dans son arrêt du 2 février 2021 (n° 17/17688), la Cour d’appel de Paris a condamné Entreparticuliers.com, qui collectait chaque jour les annonces immobilières de Leboncoin pour les transmettre à ses abonnés. La condamnation repose sur le droit des producteurs de bases de données, et non sur la concurrence déloyale : c’est l’extraction et la réutilisation de parties substantielles de la base de Leboncoin qui ont été sanctionnées, pas la technique de scraping en elle-même.
3. Les bonnes pratiques pour un scraping éthique et maîtrisé Si vous exploitez des données publiques à des fins d'analyse de marché, de veille concurrentielle (pricing) ou d'automatisation de recherche personnelle, le risque est fortement réduit quand vous respectez ces règles d'or :
Restez sur une extraction non substantielle : Ne cherchez pas à aspirer l'intégralité de la base de données de Leboncoin pour créer un clone concurrent. Ciblez uniquement les critères stricts de vos besoins.
Modérez la cadence : Limitez votre volume de requêtes pour ne pas surcharger les serveurs de la plateforme (évitezles rafales de requêtes non structuré).
Traitez les données personnelles avec précaution : Si vous récupérez des numéros de téléphone ou des noms de vendeurs, vous entrez dans le champ d'application du RGPD. Veillez à anonymiser ou à ne collecter que les attributs stricts des annonces (prix, surface, localisation, description) pour limiter tout risque lié à la vie privée.